Watchdog
Сервис Watchdog служит для сбора метрик, отслеживания неполадок в работе компонентов Платформы и управления временем жизни индексов Opensearch.
Прием необходимых для анализа метрик осуществляется путем выполнения инструкций в командной оболочке ОС по SSH, а также путем обращения к API компонентов платформы. Данные передаются в нормализованном виде для индексации и хранения в core-cluster Opensearch. Сохраняемые в кластере Opensearch события забираются модулем профилирования через Coordinator посредством Cross-Cluster Search (индекс-паттерн performance-*). Построенные по метрикам профили формируют записи в индексах metrics-profiles-* модуля Coordinator. По итогам находимых аномалий формируются списки рекомендаций с описанием возможных проблем. Метрики доступны на странице просмотра метрик (Визуализация данных о состоянии Платформы), значения профилирования могут быть просмотрены посредством компонента Opensearch-Dashboards.
В начале работы, в течение некоторого времени модуль профилирования производит большое количество ложно-положительных обнаружений аномалий в профилях, пока копятся сведения о профилях метрик компонентов. Рекомендуемое минимальное время для обучения модуля – неделя. Далее в настройках модуля в Console можно включить уведомление о находимых аномалиях и рекомендуемых действиях. Модуль построения профилей работает с интервалом в один час. Для построения профилей анализируются метрики за неделю. Для выявления аномалий анализируются профили за сутки.
Сбор метрик работает с интервалом в одну минуту. В случае превышения собранными на очередной итерации метриками заданных в конфигурации модуля пороговых значений (триггеров) производятся аварийные действия по поддержанию работоспособности либо уведомления об этих превышениях.
В потоке поддержания работоспособности непрерывно проверяются данные в кластере на предмет необходимости ротации по времени (перемещение данных, закрытие индексов, удаление индексов).
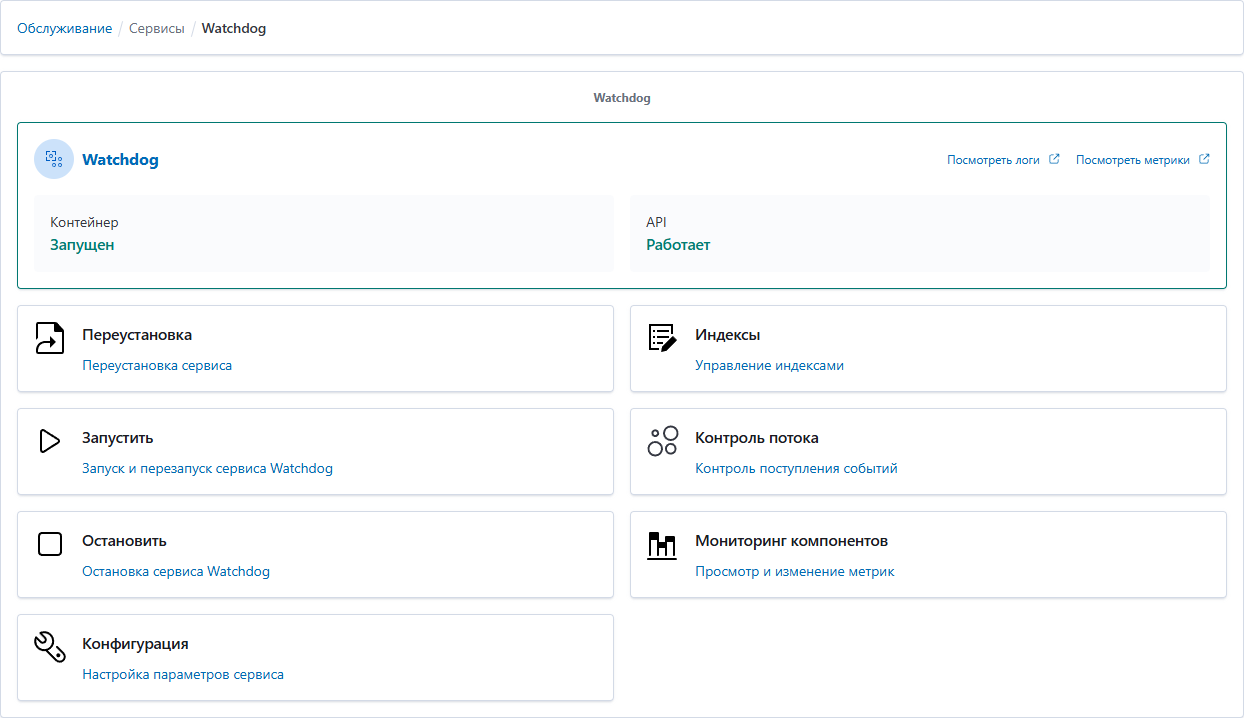
Для управления сервисом в окне управления сервисами выберите элемент "Watchdog", что приведет к отображению страницы настроек, показанной на рисунке ниже.
Рисунок 1.
Вверху страницы выводится статус контейнера сервиса (Не известно/ Запущен/ Перезапущен/ Остановлен/ Создан/ Работает с ошибками) и статус API (Не известно/ Работает/ Не работает).
По нажатию на кнопку "Посмотреть логи  " в новой вкладке браузера открывается страница просмотра логов по компоненту с предустановленным фильтром "service = watchdog", "уровень = error".
По нажатию на кнопку "Посмотреть метрики " в новой вкладке браузера открывается страница просмотра метрик с предустановленным типом "service = watchdog" (Визуализация данных о состоянии Платформы).
Имеющиеся метрики по компонентам платформы приведены в Метрики компонентов платформы. Для каждой метрики может быть добавлено уведомление по триггеру.
Триггеры, удаление которых не предусмотрено, можно переопределить, создав новый триггер на ту же метрику. Такой частный триггер можно удалить.
| Метрика | Действие |
|---|---|
Доступное место на дисках узлов кластеров | перемещение на warm-узлы (для hot-warm) или удаление старых индексов |
Количество шардов на узлах кластеров | перемещение старых индексов на warm-узлы (для hot-warm) |
Потребление места в куче JVM узлом кластера |
|
Максимальный размер шарда кластера | уведомление |
Потребление места в куче JVM ресивером | уведомление |
Потребление ресурсов ОС (память, процессор, диск) | уведомление |
Количество ошибок в логах работы компонентов | уведомление |
Остановка контейнера с компонентом (для консоли, core-кластера и postgres) | уведомление |
Имеющиеся профили метрик:
Мгновенный поток на ресивере;
Занято места на диске;
Доступно места кластеру;
Доступно места узлу;
Потребление места в куче JVM узлом кластера;
Количество шардов на узел кластера;
Время ожидания ответа от кластера;
Максимальный размер шарда в кластере;
Время обработки событий в ресивере;
Количество ошибок в ресивере;
Утилизация CPU ресивером;
Количество ожидающих задач в кластере;
Количество активных индикаторов компрометации в базе IOC-Watcher;
Время ожидания событий в очереди ресивера;
Утилизация CPU на хосте;
Потребление оперативной памяти на хосте;
Количество индексов в кластере;
Количество документов в индексах в кластере;
Ошибки записи сработок Signal в core-кластер;
Количество обнаружений Signal;
Количество правил Signal с ошибками;
Количество обнаружений иоков IOC-Watcher;
Потребление места в куче JVM ресивером.
Была ли эта страница полезной?
Спасибо за отзыв!
Спасибо, мы учтём это для улучшения документации.