Модель данных представляет собой единый шаблон, который превращает разрозненные данные из разных систем (логи, события) в понятную и структурированную схему хранения с дальнейшей возможностью автоматического построения аналитической статистики и отчётности по различным источникам.
Схема модели данных:
Схема для модели данных содержит 60 полей (см. Приложение 1). Схема модели данных предполагает хранение полученных данных от источников в хранилище на базе ClickHouse.
Текущая версия модели данных позволяет автоматизировать процесс аналитического построения контента (дашборды, профили) в Платформе при подключении источников.
1. Подключить источники в модели данных:
На текущий момент в модели данных для построения различных аналитических сценариев используются следующие источники данных.
В шаблонах коннекторов FileShare (NGR Model) и Exchange_msgtrk (NGR Model) по умолчанию в блоке input указано udp. Нужно поменять на beats.
Источник
Название коннектора (модель данных)
Netflow
nes_dp_model_netflow
FileShare (события Windows с кодами 4663, 5140, 5145, 4670 и 4656 - мониторинг доступа к объектам файловой системы)
nes_dp_model_fileshare
Exchange MSGTRK
nes_dp_model_exchange_msgtrk
Winevent (события Windows с кодами 47xx - изменения учётных записей пользователей и групп)
nes_dp_model_winevent
MS AD
nes_dp_model_ad_users
MS AD
nes_dp_model_ad_groups
2. Проверить, что данные из коннектора попадают в БД:
Перейти в раздел Данные > Хранилище и выбрать нужную БД и таблицу в ней.
3. Создать Materialized View для построения аналитических сценариев:
Реализуется с использованием python-скрипта create_mat_views.py в разделе Данные > Скрипты. Запустить один раз под конкретный источник (расписание настраивать не нужно).
4. Запустить скрипты для пополнения словарей:
В скриптах нужно указать названия таблиц перед запуском.
В следующей таблице перечислены встроенные словари.
Словарь
Назначение
Как происходит наполнение
dict_netflow_transp_proto
Словарь с транспортными протоколами, который предназначен для обогащения информации по передаваемому трафику Netflow (соответствие числовых идентификаторов протоколов в netflow данных текстовым названиям).
Список транспортных протоколов фиксированный.
После инсталляции Платформы и развертывания компонента хранения данных.
Важно! Если удалить какие-то записи по умолчанию, то при повторном развертывании компонента Хранилища они вернутся.
dict_tor_nodes
Словарь с TOR-нодами, который предназначен для обогащения информации по взаимодействию с TOR-нодами.
Скриптом tor_nodes.py в разделе Данные > Скрипты.
Важно! Не забудьте прописать в скрипте правильный SERVER_NAME (если надо - также USER_NAME и PASSWORD_DATA).
В расписании запуска скрипта необходимо установить запуск каждые 2 часа, чтобы получать актуальный список TOR-нод.
Не рекомендуется запускать скрипт более одного раза в 30 минут, т.к. на ресурсе https://www.dan.me.uk/torlist/?exit стоит блокировка по количеству запросов от IP-адреса.
Обновление скрипта будет работать только на инсталляциях с доступом в Интернет. Для инсталляций из закрытого контура необходимо подгружать скачанный актуальный список TOR-нод из файла.
dict_departments
Департаменты
Скриптом departaments.py в разделе Данные > Скрипты.
Важно!
Не забудьте прописать в скрипте правильный SERVER_NAME (если надо - также USER_NAME и PASSWORD_DATA).
Не забудьте правильно заполнить SRC именем таблицы, которая будет служить источником департаментов.
Если к Платформе подключено несколько каталогов, рекомендуется создавать средствами Платформы отдельные словари / заводить клон данного скрипта с измененными параметрами (SRC - таблица пользователь каталога, TGT - базовая таблица словаря, что вы создали).
dict_ip_fqdn
Соответствия ipv4 адресов - fqdn
Скриптом ip_fqdn.py в разделе Данные > Скрипты.
Важно!
Не забудьте прописать в скрипте правильный SERVER_NAME (если надо - также USER_NAME и PASSWORD_DATA).
Не забудьте заполнить IP_NETWORKS.
5. Проверить, что в разделах xBA и Аналитика доступны сценарии:
Данные, поступившие от источника, с помощью маппинга полей в коннекторе записываются в универсальную таблицу в ClickHouse (1 слой - Core Layer), после чего у пользователя появляется возможность выбора сценария построения аналитического контента (дашборды, профили).
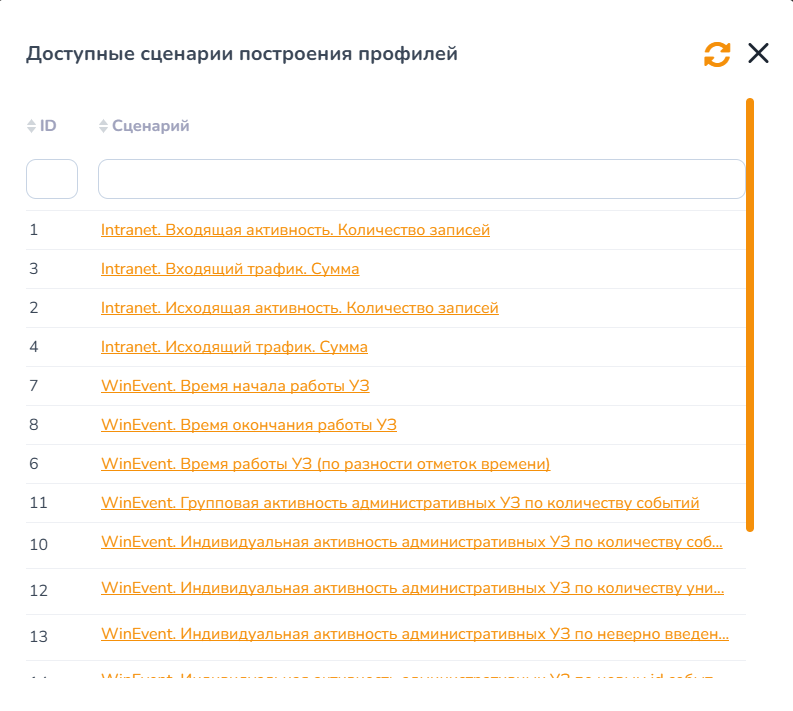
Для автоматического построения профилей пользователь переходит в раздел xBA > Профили xBA, нажимает кнопку "Доступные сценарии" и выбирает интересующий сценарий в списке.
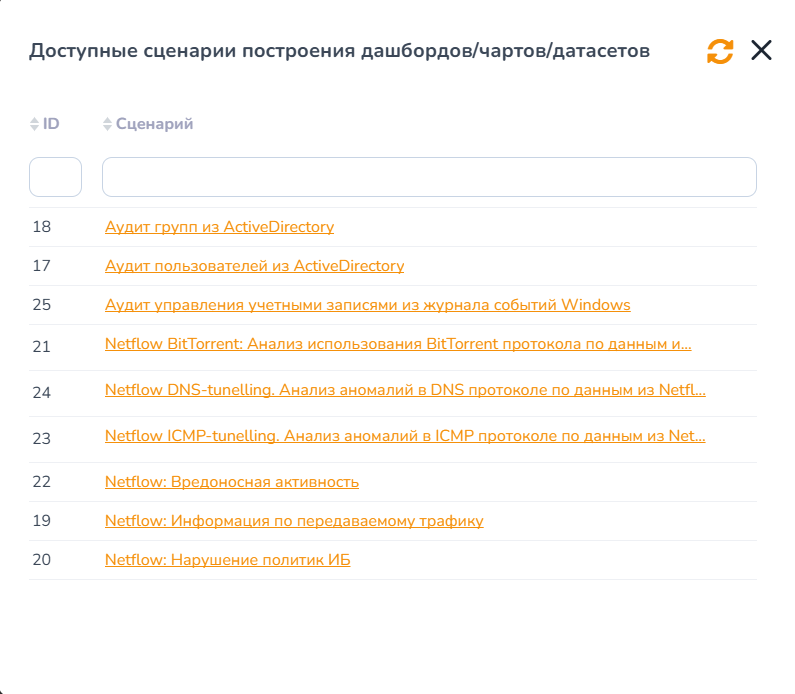
Для автоматического построения дашбордов пользователь переходит в раздел Аналитика > Дашборды, нажимает кнопку "Доступные сценарии" и выбирает интересующий сценарий в списке.
Срабатывает механизм автогенерации контента и определяется упрощенная таблица (2 слой) в зависимости от выбранного сценария.
6. Запустить новые сценарии аналитики нажатием на кнопку "Выполнить":
При запуске сценариев в качестве доступного источника обязательно выбирать mat view с пометкой mv_nes.
В следующей таблице представлены источники для автогенерации контента.
Источник
Таблица для автодашбордов
Таблица для автопрофилей
WinEvent
picker_tables.mv_nes_dp_model_winevent
picker_tables.mv_nes_dp_model_winevent
Netflow
picker_tables.mv_nes_dp_model_netflow
picker_tables.mv_nes_dp_model_netflow
Exchange MSGTRK
picker_tables.mv_nes_dp_model_exchange_msgtrk
picker_tables.mv_nes_dp_model_exchange_msgtrk
FileShare
picker_tables.mv_nes_dp_model_fileshare
picker_tables.mv_nes_dp_model_fileshare
MS AD
Работает в кейсах автоподстановка имени таблицы, поэтому здесь выбрать актуальные таблицы с данными AD.
Например, picker_tables.ad_groups и picker_tables.ad_users
Приложение выполняет подстановку имени дашборда или профиля, подстановку соответствующих БД и таблицу из сценария и генерирует новый контент в системе.
При автогенерации профилей метапрофили так же создаются автоматически.
Факт запуска сценария заносится во внутреннюю таблицу "schema_scenario_usages" со списком срабатываний.
Если в настройках хранилища для определенных сценариев включен автоматический запуск, то раз в 7 минут происходит поиск совпадения набора столбцов таблиц хранилища с наборами в схемах Платформы. Определяются таблицы, на которых еще не выполнялось срабатывание сценария, после чего запускается автоматическое создание дашборда или профиля.
Описание сценариев по модели данных:
Описание сценариев по модели данных для автоматической генерации дашбордов приводится в документе "Руководство пользователя. Часть 2".
Описание сценариев по модели данных для автоматической генерации профилей приводится в документе "Руководство пользователя. Часть 3".