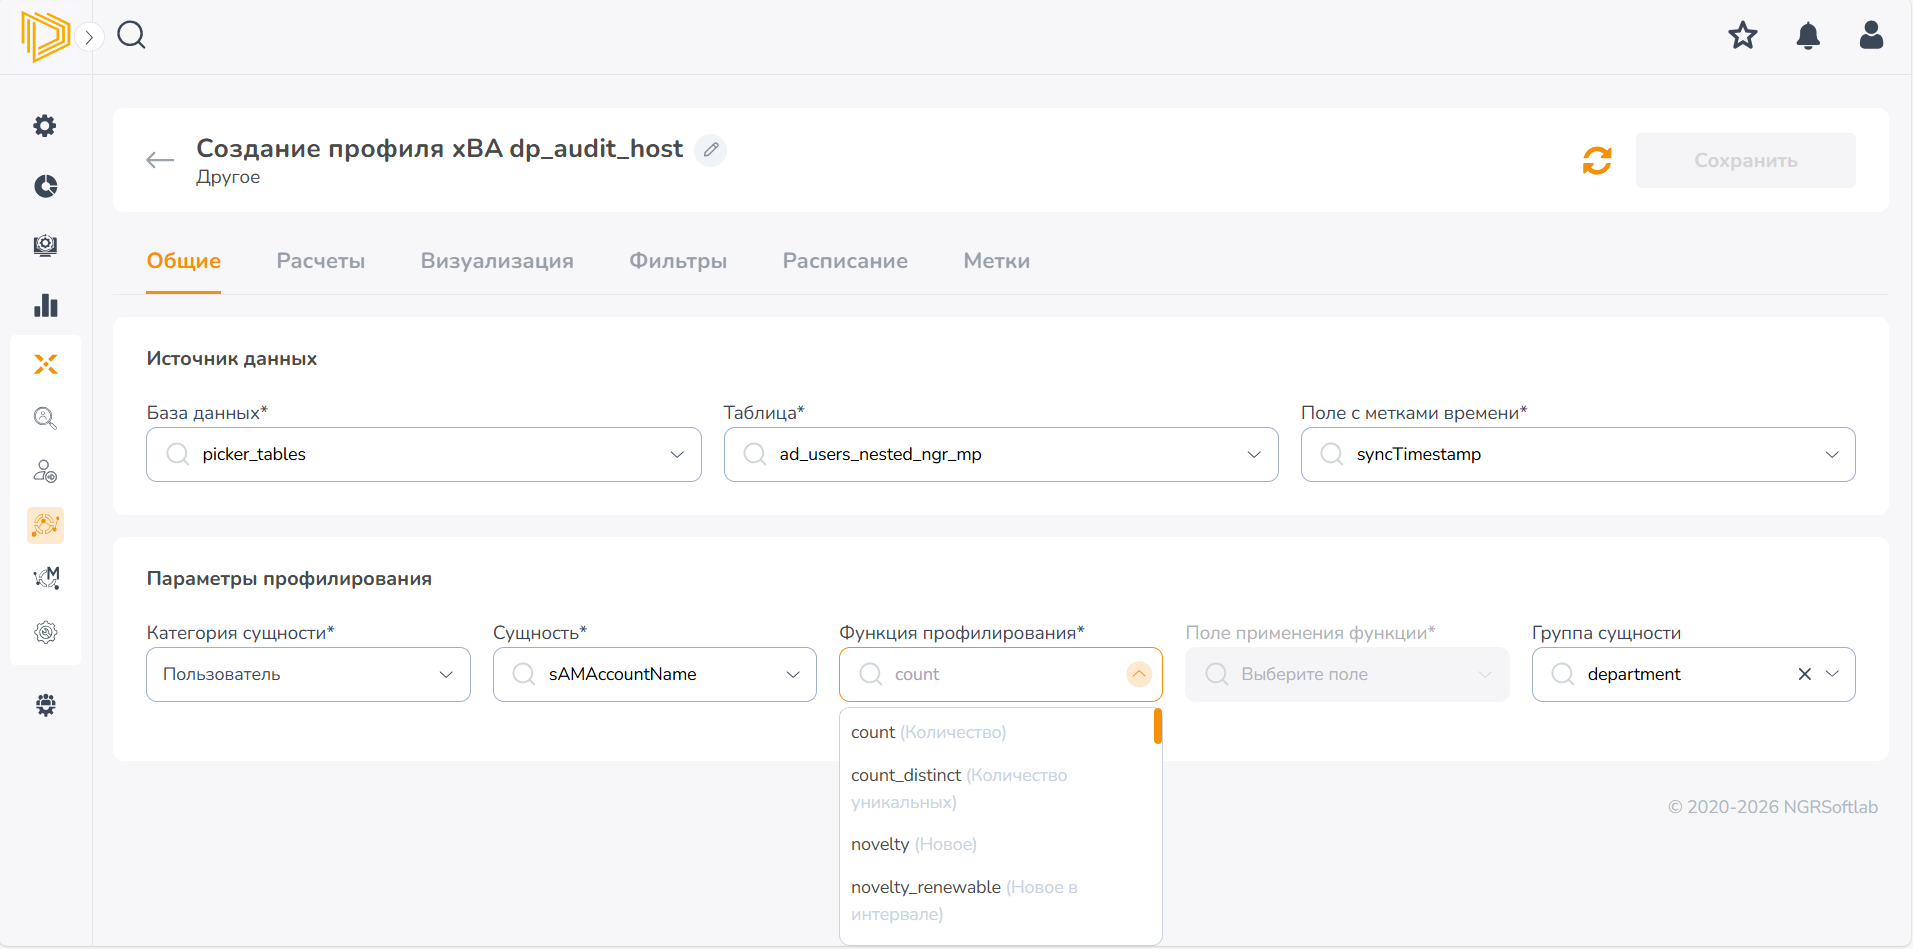
Вкладка "Общие"
Профиль формируется на основе следующих параметров:
источник данных – таблица или вью в хранилище данных;
поле временной метки – обязательное условие для анализа временных рядов;
категория сущности и поле идентификатора – например, user_sid для пользователей, host_name для хостов;
функция профилирования – ключевой параметр, определяющий, что именно анализируется.
В следующей таблице представлены общие параметры профиля.
| Параметр | Описание | Рекомендации и комментарии |
|---|---|---|
База данных | База данных в хранилище, которая является источником исходных данных | |
Таблица | Таблица исходных данных, по которой будет строиться профиль Повторный выбор БД или таблицы очищает все нижестоящие поля формы | |
Поле с метками времени | Временная характеристика, по которой будет производиться анализ поведения сущности. По нажатию на поле выпадает список столбцов типа Dat или DatT выбранной таблицы-источника |
|
Категория сущности | Категория, к которой принадлежит сущность | Зависит от сценария выявления отклонений: пользователь, хост, процесс, подразделение, другое |
Сущность | Поле с идентификатором сущности в таблице | Например, user_sid для пользователей, host_name для хостов Важно! Наименование полей в таблицах, которые используются для построения поведенческих профилей, не должны содержать дефисов, иначе возможно возникновение ошибок. Рекомендуется использовать разделитель нижнее подчеркивание ("_"). |
Функция профилирования | Функция, с помощью которой будет рассчитываться профиль. По умолчанию указана функция count (Количество) | В выпадающем списке содержатся латинские названия функций (см. таблицу ниже), в скобках указано русское наименование. При наведении курсора на выбранную функцию отображается всплывающая подсказка с описанием функции. Важно! Если в "Поле с метками времени" выбран столбец с типом данных Dat, то функции работы со временем (*_log_time, len_distinct_hour, hourly_activity) недоступны к выбору в поле "Функция профилирования". |
Поле применения функции | Поле применения функции зависит от выбранной функции | Если для выбранной функции есть доступные типы данных, выберите столбец, для которого будет применяться данная функция расчета. Например, url для подсчета уникальных посещенных ресурсов. Для некоторых функций поле будет заблокировано (см. таблицу ниже). |
Группа сущности | Дополнительный признак для расчета отклонений относительно однородной группы, который характеризует сущность и влияет на групповые риски | Например, для сущности "Пользователь" может быть выбрана группа сущности "Департамент", для сущности "Хост" может быть выбрана группа "Протокол". Выбор данного столбца позволит получать статистику распределения рисков по группам и анализировать поведение сущности в рамках конкретной группы, а также настраивать фильтрацию отображения данных на странице просмотра профиля только по определенной группе. Количество уникальных записей в столбце с группами сущностей не ограничено. |
В следующей таблице приведено описание функций профилирования xBA.
| № п.п. | Латинское название функции | Русское название функции | Требуется ли указать поле применения функции? | Тип данных поля применения функции | Описание функции | Пример применения |
|---|---|---|---|---|---|---|
1 блок | ||||||
count | Количество | нет расчет выполняется по количеству записей в хранилище для сущности за период дискретизации | - | Поиск отклонений по количеству значений | Пользователи с максимальной активностью в логах | |
count_distinct | Количество уникальных | да | все типы | Поиск отклонений по количеству уникальных значений | Количество различных IP для одной УЗ | |
novelty | Новое | да | num, dat, datT, cat, keyword | Поиск отклонений по новым значениям | Доступ к новой таблице, к которой ранее не обращались | |
novelty_renewable | Новое в интервале | да | num, dat, datT, cat, keyword | Поиск отклонений по новым значениям в интервале | Появление ранее не встречавшегося процесса в рамках определенного интервала времени | |
group_novelty | Новое по группе | да | num, dat, datT, cat, keyword | Поиск отклонений по новым значениям в сравнении с группой сущностей | Обращение к ресурсу, нетипичному для других сотрудников этого же подразделения | |
2 блок | ||||||
avg | Среднее | да | числовой (num) | Поиск отклонений по среднему значению | Среднее количество строк, выгруженных из БД | |
min | Минимальное | да | числовой (num) | Поиск отклонений по минимальному значению | Минимальное количество строк, выгруженных из БД за день | |
max | Максимальное | да | числовой (num) | Поиск отклонений по максимальному значению | Максимальное количество строк, выгруженных из БД за день | |
sum | Сумма | да | числовой (num) | Поиск отклонений по сумме значений | Сумма строк, выгруженных из БД | |
avg_not_zero | Среднее ненулевых | да | числовой (num) | Поиск отклонений по среднему ненулевых значений | Среднее количество непустых строк, выгруженных из БД | |
percentile_99 | Перцентиль 99 | да | числовой (num) | Поиск отклонений по перцентилю 99 | Набор данных фиксирует ежедневную активность сотрудников при обращении к различным внутренним веб-приложениям компании. Для каждого сотрудника за день собирается набор записей, где каждая запись соответствует продолжительности отдельной пользовательской сессии в секундах. В нормальной ситуации типичная продолжительность пользовательской сессии составляет около 50 секунд, с незначительными колебаниями в пределах дня. Однако у некоторых пользователей в отдельные периоды появляются слишком долгие сессии (например, продолжительностью свыше 80 секунд и более), что может быть признаком компрометации учетной записи, несанкционированного доступа или проведения операций, требующих необычно длительного времени (например, массовое скачивание документов, разведка внутренней информации и т.д.). Поиск отклонений по перцентилям позволяет оперативно выявлять сотрудников с потенциально необычным поведением, поскольку кратковременные скачки активности существенно влияют именно на верхние перцентили, при этом средние значения остаются относительно стабильными и менее информативными для выявления подобных отклонений. | |
percentile_95 | Перцентиль 95 | да | числовой (num) | Поиск отклонений по перцентилю 95 | ||
percentile_90 | Перцентиль 90 | да | числовой (num) | Поиск отклонений по перцентилю 90 | ||
percentile_10 | Перцентиль 10 | да | числовой (num) | Поиск отклонений по перцентилю 10 | ||
percentile_5 | Перцентиль 5 | да | числовой (num) | Поиск отклонений по перцентилю 5 | ||
log_avg | Логарифм среднего | да | числовой (num) | Поиск отклонений по логарифму среднего значения | Среднее количество строк, выгруженных из БД | |
log_min | Логарифм минимального | да | числовой (num) | Поиск отклонений по логарифму минимального значения | Минимальное количество строк, выгруженных из БД за день | |
log_max | Логарифм максимального | да | числовой (num) | Поиск отклонений по логарифму максимального значения | Максимальное количество строк, выгруженных из БД за день | |
log_sum | Логарифм суммы | да | числовой (num) | Поиск отклонений по логарифму суммы значения | Логарифм суммы строк, выгруженных из БД | |
3 блок | ||||||
max_log_time | Максимальное время | нет расчет выполняется относительно поля времени | - | Поиск отклонений по максимальной отметке времени | Нетипичное время окончания работы за день | |
min_log_time | Минимальное время | нет расчет выполняется относительно поля времени | - | Поиск отклонений по минимальной отметке времени | Нетипичное время начало работы за день | |
delta_log_time | Разница времени | нет расчет выполняется относительно поля времени | - | Поиск отклонений по разнице между максимальной и минимальной отметками времени | Нетипичная продолжительность работы по разнице максимального и минимального времени | |
len_distinct_hour | Количество уникальных часов | нет расчет выполняется относительно поля времени | - | Поиск отклонений по количеству уникальных значений часов в отметках времени | Нетипичная продолжительность работы по количеству различных часов, по которым есть записи в таблице | |
hourly_activity | Почасовая активность | нет расчет выполняется относительно поля времени | - | Поиск отклонений по распределению активности по часам в течение дня | Набор данных фиксирует распределение активности сотрудников по часам суток (от 0 до 23 часов), исходя из записей в логах внутренней инфраструктуры компании. Для каждого сотрудника формируется почасовая гистограмма, отражающая частоту активности в определённые часы дня. В нормальном состоянии сотрудники имеют стабильный индивидуальный паттерн активности, который варьируется незначительно в рамках типичных рабочих дней. Существенные изменения такого паттерна могут указывать на потенциальную угрозу: несанкционированный доступ, компрометацию учётной записи или иные подозрительные действия, связанные с необычной временной активностью (например, доступ в ночные или нерабочие часы, резкие изменения активности в определённое время суток и др.). | |
regularity | Регулярность | нет расчет выполняется относительно поля времени | - | Поиск отклонений по регулярности событий в привязке к отметке времени | Измеряет регулярность повторения событий от 0 до 100 относительно индивидуального доверительного интервала в рамках длин скользящего окна (например: 45 дней) 0 - полностью хаотичный характер (реалистичный минимум ≈ 20–25 для очень хаотичного поведения) 100 - полная регулярность событий, например, запуск скрипта ровно в 10:00 каждый день | |
4 блок | ||||||
distr_dvrg | Схожесть распределения | да | num, dat, datT, cat, keyword | Поиск отклонений по измерению схожести распределения количества событий | Например, пользователь обращается каждый день к 2 системам А и В, причем обычно к системе А обращается в несколько раз чаще, чем к системе В. Профиль distr_dvrg позволяет проанализировать пропорции обращения к разным системам и будет выдавать отклонения, только когда изменилось соотношение между А и В, например, к В стали обращаться чаще, чем к А. | |
entropy | Энтропия | да | num, dat, datT, cat, keyword | Поиск отклонений по энтропии значений выбранного параметра | Функция позволяет отслеживать использование сотрудниками роботизированных учетных записей, когда это запрещено. Энтропия показывает, насколько разнообразны или регулярны события в рамках текущего периода дискретизации. Высокая энтропия - данные разнообразные, хаотичные. Низкая энтропия - данные однообразные, предсказуемые. Например, если одна УЗ каждый день на протяжении долгого времени делает одинаковые действия (1000 раз обращается к БД1, 5000 раз обращается к БД2), то это указывает на высокую регулярность событий и может означать, что применяется скрипт/сервис. | |
Была ли эта страница полезной?
Спасибо за отзыв!
Спасибо, мы учтём это для улучшения документации.